Une page de référence disparaît, un article est réécrit, un outil change d’adresse : les liens sur lesquels vous vous appuyez ne durent pas toujours. ArchiveBox propose d’en conserver une copie chez vous. Ce logiciel libre d’archivage du web, à héberger soi-même, enregistre les pages que vous lui donnez (une adresse, une liste, un export de favoris ou d’historique) en plusieurs formats : HTML, PDF, capture d’écran, WARC… Il est en version 0.9 : son paquet PyPI est classé « Beta » et son API REST est présentée comme « alpha ». Voici ce qu’il conserve, comment l’installer avec Docker Compose et les limites à connaître.
ArchiveBox, c’est quoi ?
ArchiveBox est une application web, pilotable aussi en ligne de commande, qui enregistre des pages web sur votre propre serveur, dans des fichiers ordinaires que vous pouvez lire sans lui. Le projet la présente comme un outil d’archivage du web open source et auto-hébergé.
- Open source : le code est public sur GitHub. Il est écrit en Python, avec Django ; la base est SQLite par défaut, et PostgreSQL est possible depuis la version 0.9. L’outil s’appuie sur Chrome, wget et yt-dlp.
- Version 0.9 : annoncée le 22 septembre 2026 comme la première version majeure depuis 2024, avec un nouveau moteur d’archivage, des applications mobiles et de bureau et plus de 50 plugins annoncés.
- Un projet connu et actif : présenté sur Hacker News dès 2019, plus de 28 000 étoiles sur GitHub, des versions publiées très régulièrement. Le logiciel est gratuit ; le projet accepte les dons, et le README liste des hébergeurs tiers payants.

Ce qu’ArchiveBox conserve
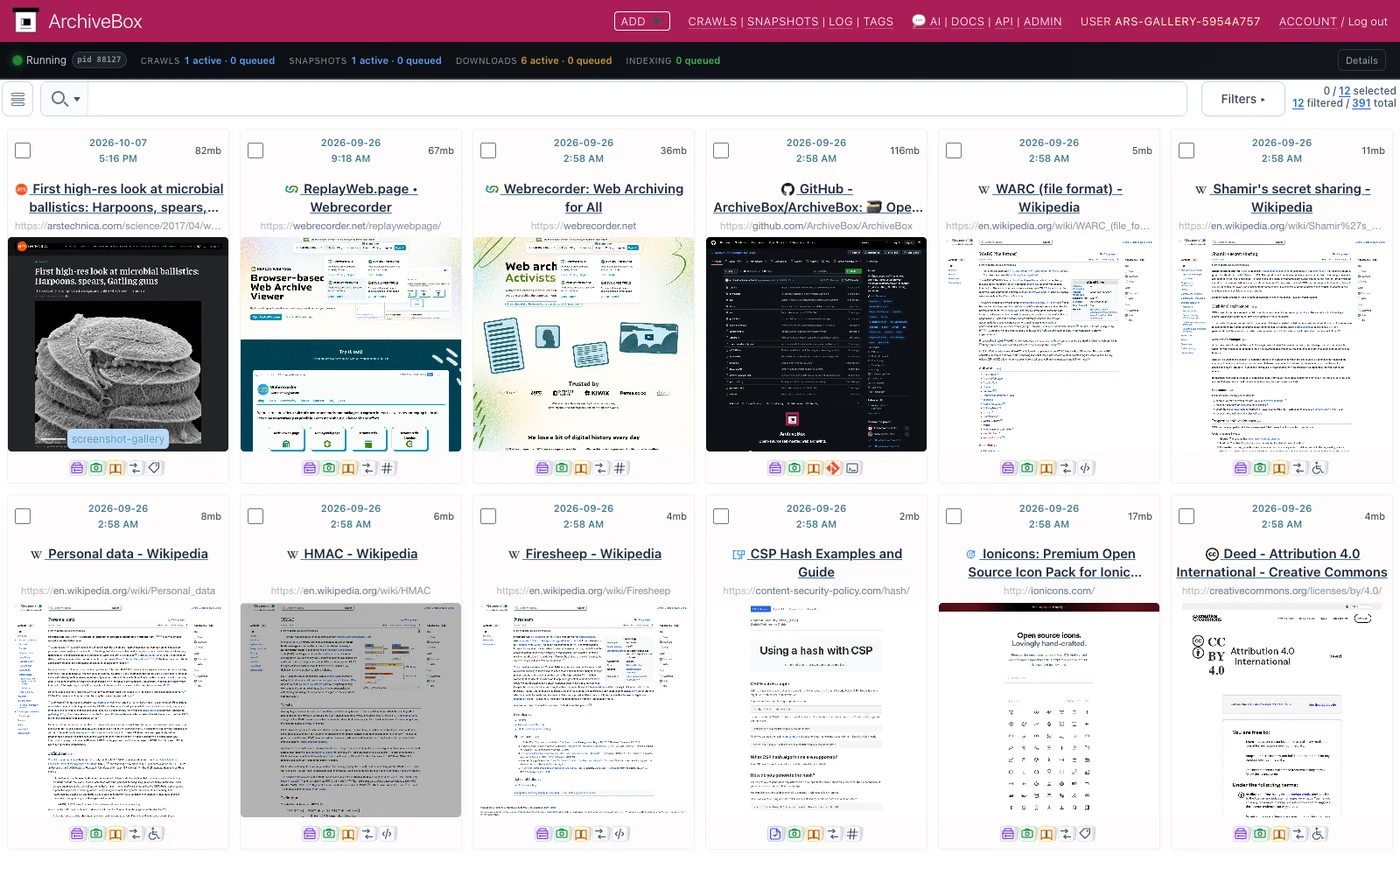
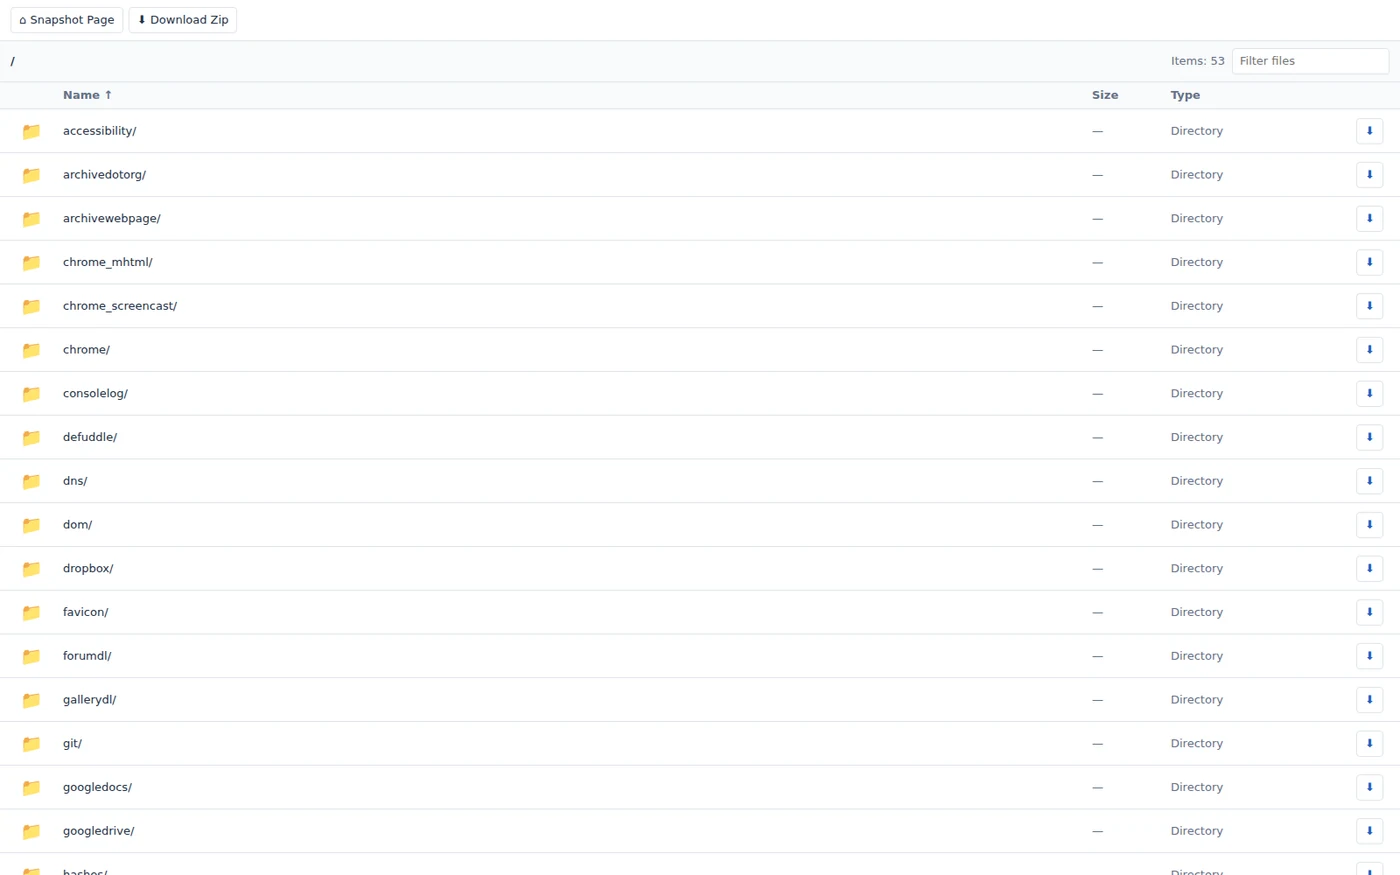
Pour chaque adresse, ArchiveBox crée un dossier et y range plusieurs copies de la même page. D’après le README, on y trouve notamment :
- le HTML d’origine (copie wget) et une version « SingleFile », un fichier HTML unique rendu par Chrome ;
- un PDF, une capture d’écran en PNG et le DOM après rendu ;
- un fichier WARC, format standard d’archive web ;
- le texte de l’article, le titre, l’icône du site et les en-têtes de réponse ;
- l’audio et la vidéo (yt-dlp), et un clone du code pour les liens vers GitHub, GitLab ou Bitbucket.

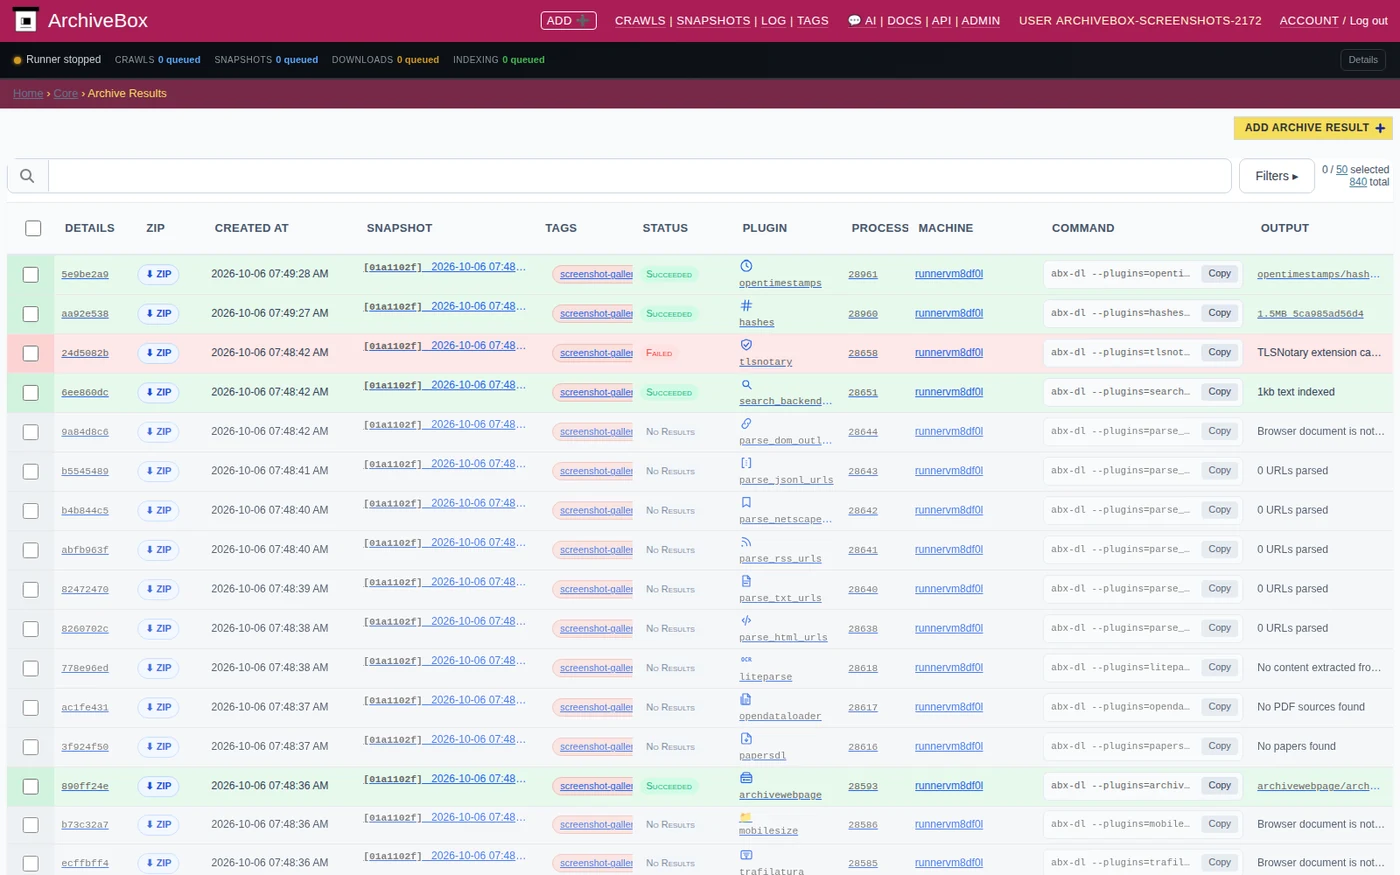
Dans l’interface, chaque résultat d’extraction correspond à un extracteur et porte un statut (réussi, échoué ou sans résultat).

Ce qui n’est pas conservé, ou mal
- Le JavaScript au rejeu : sur un nom de domaine ordinaire, le mode de sécurité par défaut affiche le HTML archivé sans exécuter son JavaScript. Le rejeu complet demande des sous-domaines isolés (DNS et certificat « wildcard »). La version SingleFile reste lisible, ses scripts étant retirés à la capture.
- Les sites protégés : le README note que de nombreux grands sites (Reddit, Twitter, Cloudflare…) bloquent l’archivage. Une page derrière une connexion demande un profil Chrome et des cookies (les « personas »), avec des réserves de sécurité. Pour les pages très interactives, il renvoie vers ArchiveWeb.page.
- Les vidéos : elles sont enregistrées, mais font gonfler l’archive : le README annonce environ 1 à 50 Go pour 1 000 captures, selon que vous gardez l’audio et la vidéo.
Ajouter des pages et les retrouver
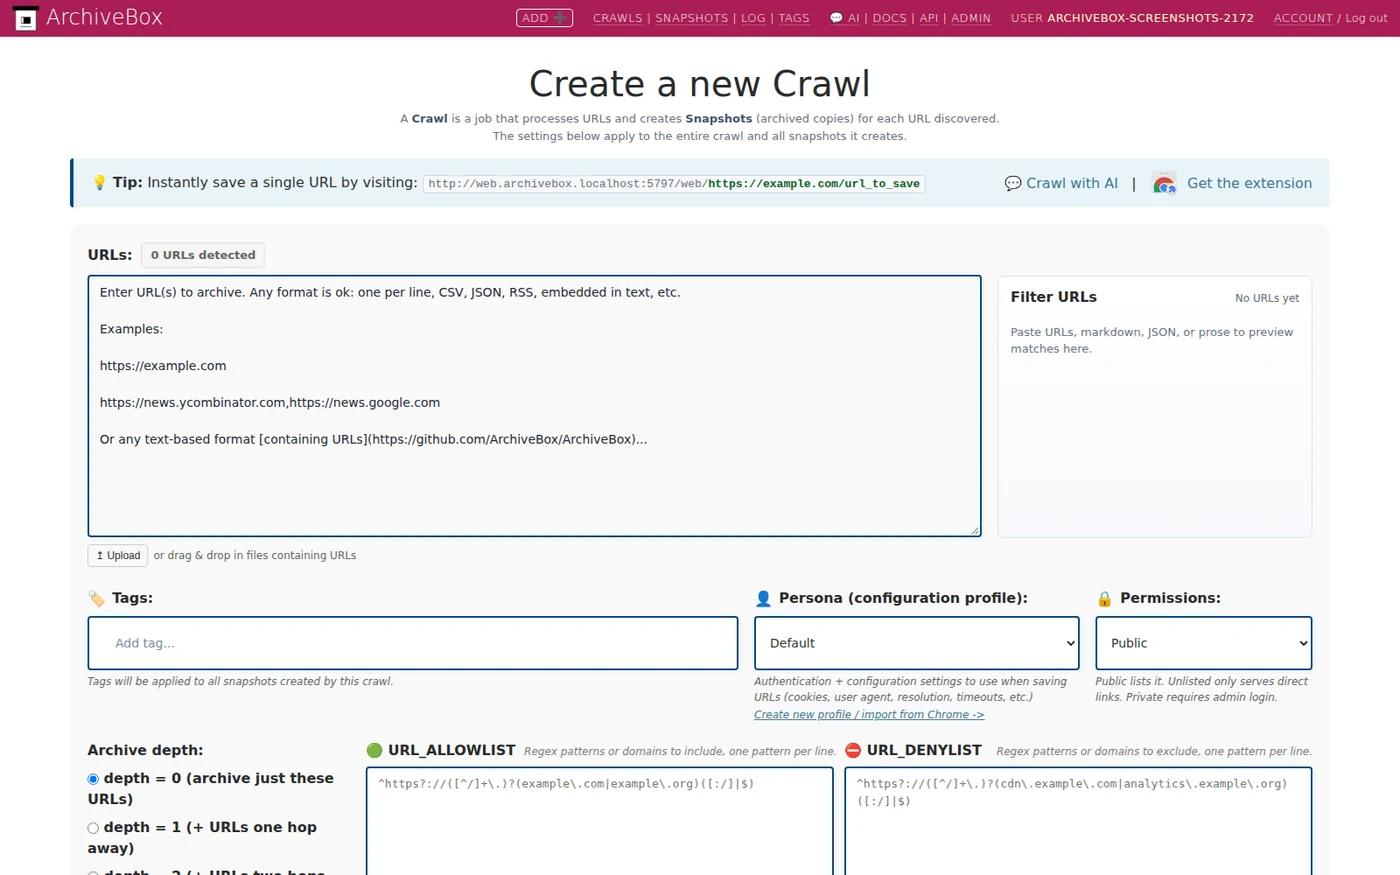
Plusieurs chemins mènent à ArchiveBox : le formulaire de l’interface web, la ligne de commande (archivebox add), l’API REST (annoncée en alpha), les webhooks, l’extension de navigateur et les applications du projet (iPhone, iPad, Android en bêta, Mac, Windows, Linux). Le formulaire accepte des adresses collées en vrac (une par ligne, CSV, JSON, RSS ou noyées dans un texte) et propose étiquettes, profil et permissions.

On peut aussi importer des listes existantes : le README cite l’historique et les favoris du navigateur (export au format Netscape), les flux RSS et les exports de services comme Pocket ou Pinboard. La commande archivebox schedule programme des imports réguliers, traités par le serveur lui-même. Pour la recherche plein texte, Sonic est le moteur choisi par défaut dans l’interface, avec ripgrep en secours.
Comment l’installer
Le projet recommande Docker Compose, sur amd64 ou arm64. La documentation d’installation demande 1 Go de mémoire au minimum et recommande 2 Go ou plus ; sur un serveur de 1 Go, elle conseille au moins 4 Go de swap avant de lancer des captures complètes. Il existe aussi des installations par uv ou pip (Python 3.13), apt et Homebrew.
Avec Docker Compose
# Dossier de travail, puis téléchargement du fichier Compose officiel
mkdir -p ~/archivebox/data && cd ~/archivebox
curl -fsSL 'https://docker-compose.archivebox.io' > docker-compose.yml
docker compose pull
docker compose up -d --wait
Le fichier officiel prend par défaut l’étiquette latest de l’image (variable ARCHIVEBOX_IMAGE). Le README propose aussi l’étiquette dev, qui n’avance qu’après la réussite de toute l’intégration continue. Voici l’essentiel du service, avec BASE_URL à remplacer par votre adresse :
# docker-compose.yml : essentiel du fichier officiel (commentaires retirés, adresse à adapter)
services:
archivebox:
image: ${ARCHIVEBOX_IMAGE:-archivebox/archivebox:latest}
restart: unless-stopped
ports:
- "${ARCHIVEBOX_PORT:-5797}:5797"
volumes:
- ./data:/data
- tmp:/tmp/archivebox
environment:
- BASE_URL=https://archive.example.com
- PUBLIC_ADD_VIEW=False
# Optionnel : créer le compte administrateur au premier lancement
# - ADMIN_USERNAME=admin
# - ADMIN_PASSWORD=VOTRE_MOT_DE_PASSE
shm_size: "1gb"
pids_limit: 2048
volumes:
tmp:
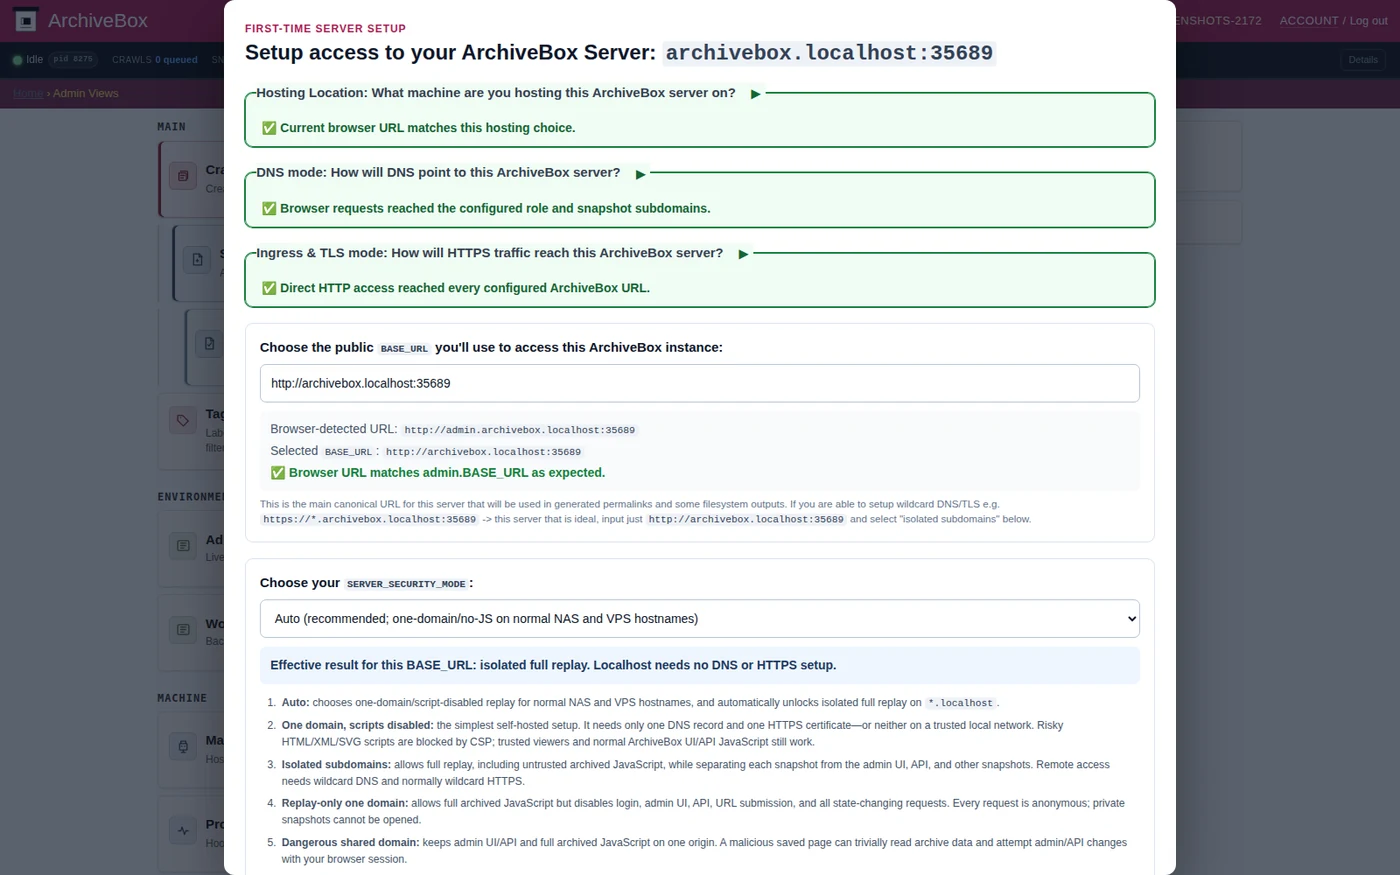
La documentation présente BASE_URL comme l’adresse publique canonique de l’instance, qui sert de référence pour construire les liens : renseignez-la dès le départ avec l’adresse https complète. L’assistant de premier lancement la demande, puis le mode de sécurité ; un serveur déjà configuré saute cet assistant. Le mode par défaut, SERVER_SECURITY_MODE=auto, n’utilise des sous-domaines que pour les adresses en *.localhost et un seul hôte pour les autres.

Ouvrez ensuite /admin/ sur l’adresse de votre serveur (en local, http://admin.archivebox.localhost:5797/admin/) pour créer le premier compte administrateur et terminer l’assistant. Pour un accès public en HTTPS, cet assistant indique les réglages de DNS, d’amont et de certificat à saisir dans votre proxy (Cloudflare, Nginx Proxy Manager, Caddy, Traefik, Tailscale…). Archivez ensuite une première page :
docker compose exec archivebox archivebox add 'https://example.com'
Les limites à connaître
- Un projet encore jeune sur certains points : paquet « Beta » sur PyPI, API REST « alpha » et API Python « bêta » dans le README. Le passage de la 0.7 à la 0.9 déplace des fichiers : les notes de version demandent une sauvegarde complète (base, configuration, archives, profils de navigateur) puis une commande de migration. Sur Hacker News, un utilisateur venu de la 0.7 signalait des icônes absentes puis des liens cassés ; le mainteneur a corrigé en quelques jours.
- Le stockage et la mémoire : 1 à 50 Go pour 1 000 captures (chiffres du README), l’index SQLite devant rester sur un disque local fiable. La capture avec Chrome consomme de la mémoire : la documentation permet de la désactiver sur un petit serveur. Un utilisateur avait arrêté l’outil à cause d’un Chromium qui se bloquait presque chaque jour ; le mainteneur assure que la 0.9 corrige ce défaut.
- L’envoi vers archive.org : par défaut, ArchiveBox soumet aussi les pages à archive.org, sans filtrer les adresses : un jeton secret placé dans une URL y deviendrait visible. Le réglage
ARCHIVEDOTORG_ENABLED=Falsele désactive. Un utilisateur a reproché ce défaut au projet en 2024. - Le contenu privé : cookies, jetons de session et adresses secrètes se retrouvent dans les captures (en-têtes comprises), visibles par quiconque consulte l’archive. La documentation de sécurité déconseille d’utiliser votre profil Chrome personnel ; le README propose de restreindre l’accès à l’index.
- Le JavaScript archivé n’est pas fiable : l’afficher sur la même origine que l’administration est un risque, et la documentation déconseille de servir ArchiveBox depuis un sous-dossier d’un autre site. Définissez
BASE_URLdès le départ. - Un mainteneur principal : en 2024, il décrivait sept ans de travail en solo, sur son temps libre, et reconnaissait des défauts de certaines versions.
- Le droit : le README rappelle que copier le contenu d’autrui relève de votre responsabilité ; prévoyez une procédure de retrait si vous publiez une instance.
ArchiveBox face à la Wayback Machine, Linkwarden et SingleFile
La Wayback Machine est un service public ; ArchiveBox est une archive que vous hébergez et dont vous réglez les accès. Les éléments ci-dessous viennent des pages officielles de la Wayback Machine, de Linkwarden et de SingleFile.
| Solution | Où sont les copies | Ce qui est conservé | À savoir |
|---|---|---|---|
| Sur votre serveur (open source) | Plusieurs formats par page : HTML, PDF, capture, WARC, médias | Interface, ligne de commande et API ; stockage lourd ; maintenance à votre charge | |
| Chez Internet Archive, avec une adresse permanente | Via Save Page Now : une seule page, avec ses images et son CSS, sans les liens sortants | Certains sites interdisent l’exploration ; pas de parcours d’un site entier ; Archive-It, payant, pour les organisations | |
| Sur votre serveur, ou offre cloud payante | Capture d’écran, PDF et fichier HTML unique de chaque lien | Gestionnaire de favoris collaboratif avec vue lecture annotable ; envoi optionnel vers la Wayback Machine | |
| Dans votre navigateur (fichier local) | Une page complète dans un seul fichier HTML | Extension et ligne de commande ; annotation, sauvegarde automatique des onglets, envoi possible vers Google Drive ou GitHub |
Logos des outils cités : marques de leurs projets, reproduits à titre d’illustration d’après leurs dépôts officiels, et Wikimedia Commons pour Internet Archive.
Le README d’ArchiveBox oriente lui-même vers d’autres outils selon le besoin : ArchiveWeb.page pour mieux restituer des pages très interactives, Linkwarden pour classer et annoter des favoris, Browsertrix pour parcourir des sites en profondeur. Il reconnaît qu’ArchiveBox n’est ni l’outil le plus fidèle ni le plus simple : un touche-à-tout qui cherche à bien faire l’essentiel par défaut. ArchiveBox utilise d’ailleurs SingleFile pour l’un de ses extracteurs.
Pour qui ?
ArchiveBox convient aux indépendants, agences et petites équipes qui veulent garder, sur leur propre serveur, des copies de pages de référence ou de documentation susceptibles de changer ou de disparaître, et qui sont à l’aise avec Docker. Il convient moins à qui n’a besoin que d’une copie ponctuelle (la Wayback Machine ou SingleFile suffisent), à qui dispose d’un serveur très juste en mémoire ou en disque, ou à qui veut archiver des contenus privés sans prévoir leur protection.
En résumé
ArchiveBox est un outil open source et auto-hébergé qui garde plusieurs copies d’une page (HTML, PDF, capture, WARC…) dans des fichiers lisibles sans lui. Il est en version 0.9 : paquet « Beta » sur PyPI, API REST « alpha », développement très actif. À vous de prévoir le stockage, les sauvegardes, la mémoire du serveur et la sécurité (BASE_URL, envoi vers archive.org, contenus privés). Si vous déployez vos outils avec Coolify, notre article sur Coolify montre comment le faire en quelques clics. Pour de l’aide à l’installation et à la maintenance d’ArchiveBox, parlez-nous de votre projet.