
Cloner une voix, doubler une vidéo ou transcrire un enregistrement passe souvent par un service en ligne : on envoie ses fichiers audio à un tiers et on paie au crédit. VoiceStudio prend le contre-pied : c’est une application qui fait tout cela sur votre propre ordinateur, sans compte. Son éditeur annonce le clonage de voix, la conception de voix à partir d’une description, le doublage de vidéos, la dictée, la transcription et la création de livres audio, dans 646 langues annoncées. Elle existe pour macOS, Windows, Linux et Docker, avec des applications mobiles encore en préversion. Voici ses fonctions, son installation, ses éditions libre et payante, ses limites et la question du consentement.
VoiceStudio, c’est quoi ?
VoiceStudio est une application de bureau, qui existe aussi sous forme d’interface web servie par Docker. Elle regroupe des moteurs de synthèse vocale, de reconnaissance vocale et de traduction. Le moteur de synthèse par défaut est OmniVoice (k2-fsa/OmniVoice, d’après le dépôt) ; des dizaines d’autres moteurs, selon le dépôt, se choisissent dans un gestionnaire de modèles, et l’application demande avant de télécharger un modèle. D’après les messages de son auteur sur Hacker News, le projet s’appelait auparavant OmniVoice Studio : ce nom reste visible dans certains noms de conteneurs de la documentation Docker.
- Open source : le code de l’application est public sur GitHub.
- Local : le traitement se fait sur votre machine. Le site précise que VoiceStudio ne se connecte à Internet que pour vérifier les mises à jour ou télécharger un modèle, sans compte ni clé d’API.
- Maturité : le dépôt classe macOS (Apple Silicon), Windows, Linux et Docker en « stable », Android et iOS en « préversion » et Windows ARM en « expérimental ». Les versions portent encore un numéro 0.x.
Les fonctions principales
Cloner ou concevoir une voix
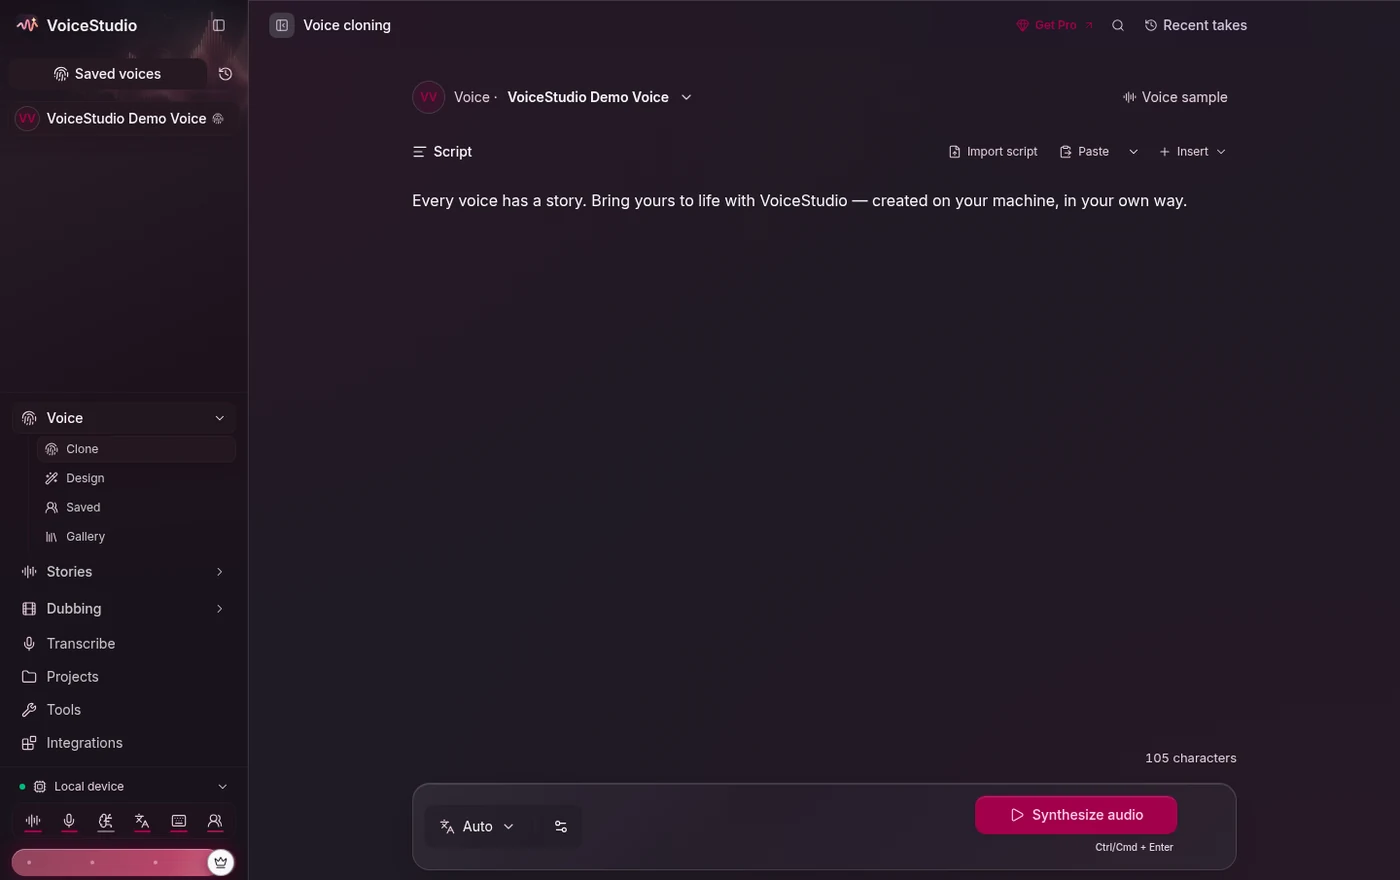
Pour cloner une voix dans VoiceStudio, vous choisissez la voix de démonstration ou ajoutez un enregistrement de référence propre, vous saisissez le texte et vous lancez la synthèse. Le site affirme que trois secondes d’audio net suffisent en général ; c’est une affirmation du projet.
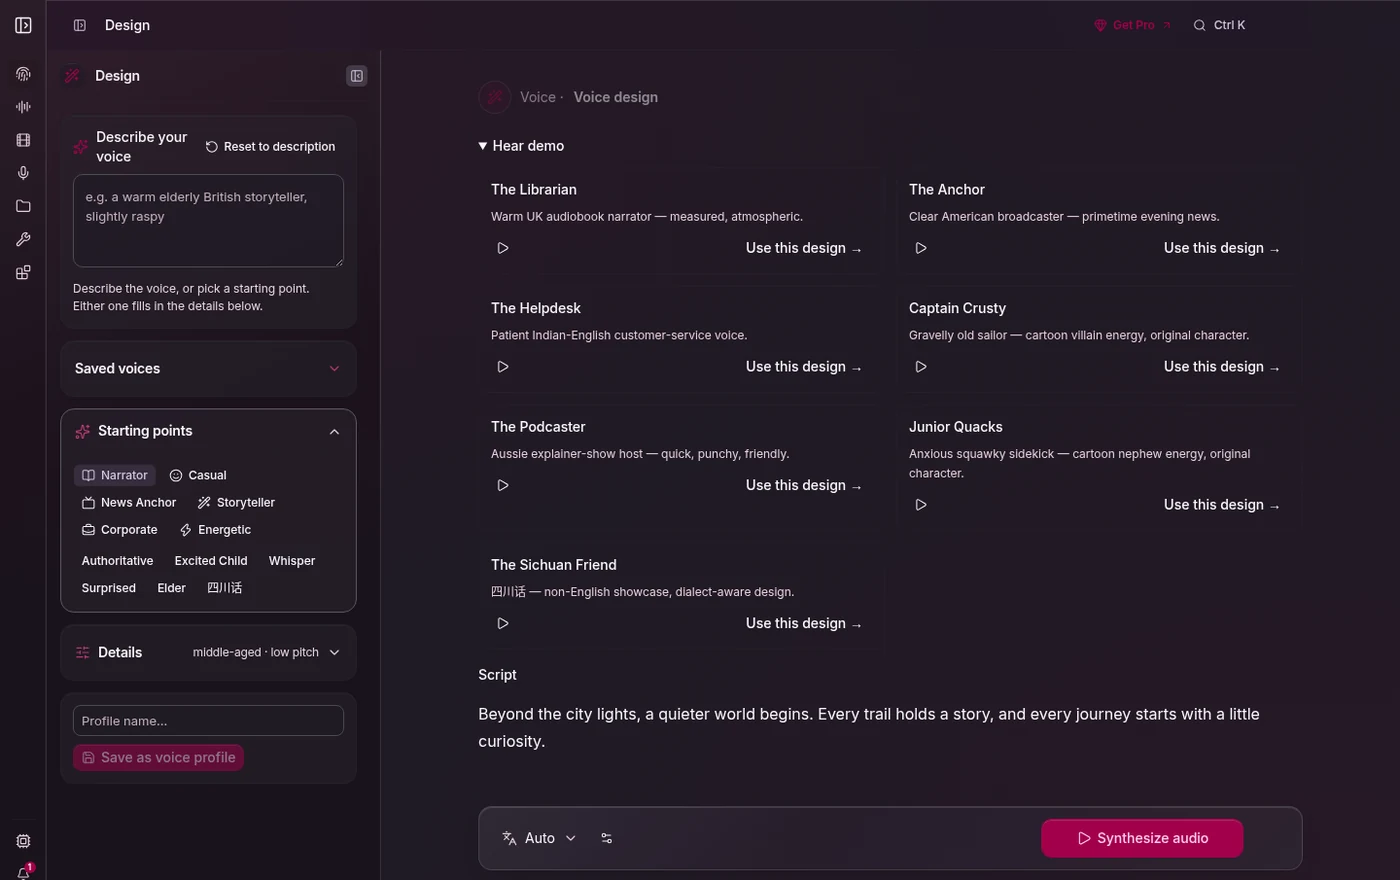
La conception de voix n’exige aucun enregistrement : vous décrivez en une phrase le genre, l’âge, l’accent, la hauteur ou l’émotion souhaités. L’interface propose des points de départ (narrateur, présentateur, conteur, voix énergique…) et des exemples à écouter avant de créer votre propre profil de voix.
Doubler une vidéo
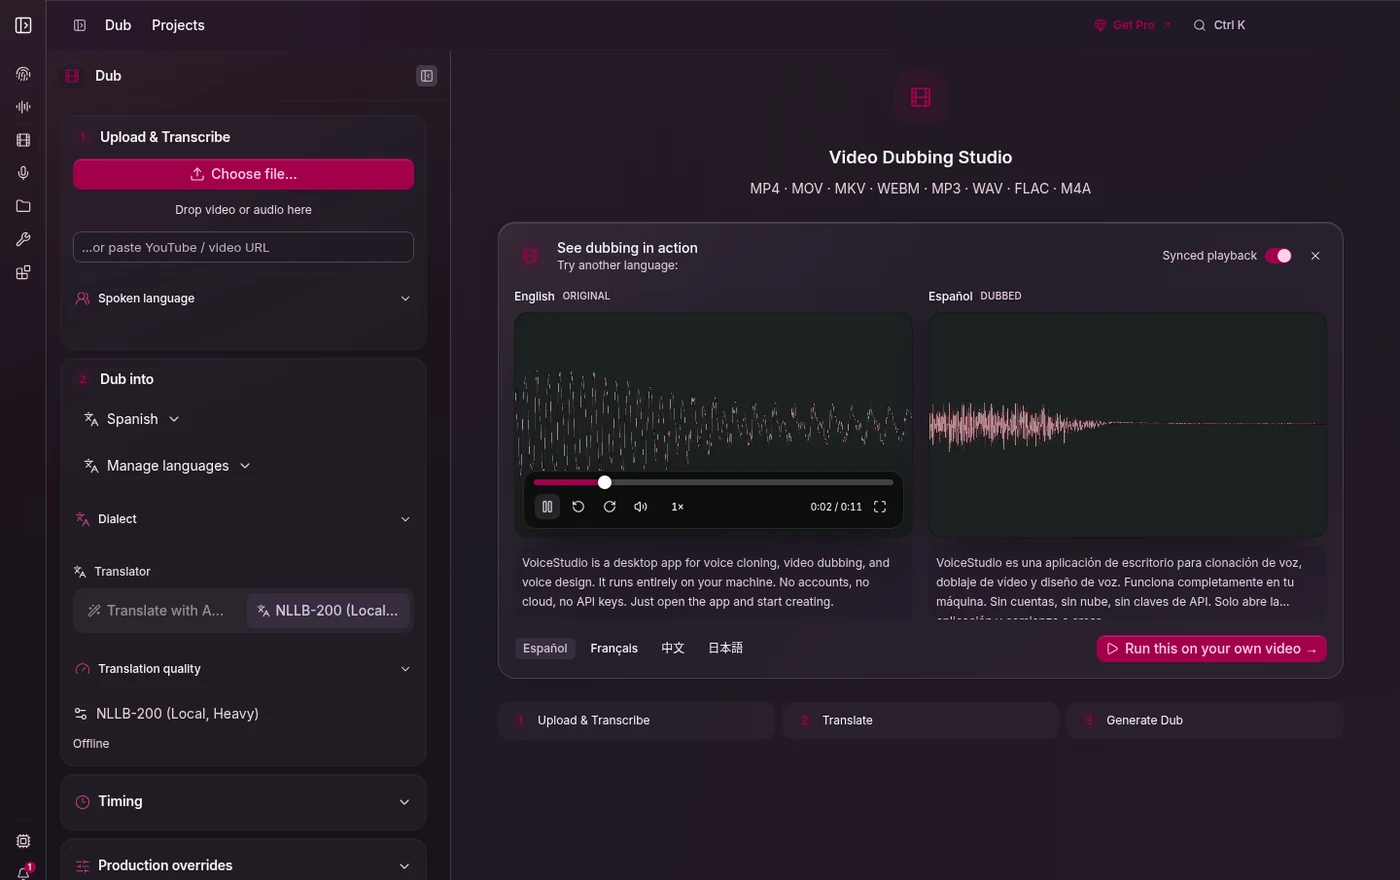
Le module de doublage de VoiceStudio transcrit une vidéo ou un fichier audio, traduit le texte, puis refait la voix dans une autre langue. D’après le site, chaque locuteur reste distinct et le timing suit l’original. On dépose un fichier (MP4, MOV, MKV, WebM, MP3, WAV, FLAC ou M4A, selon l’écran) ou on colle une adresse YouTube ou vidéo. La capture montre un modèle de traduction qui tourne en local (NLLB-200), à côté d’une option de traduction par IA.
Dictée, transcription, livres audio et automatisation
- Dictée et transcription : VoiceStudio propose un widget de dictée flottant et plusieurs moteurs de reconnaissance vocale (WhisperX est le moteur par défaut du catalogue).
- Livres audio et travaux par lots : des histoires, des livres audio et des files de traitement pour enchaîner plusieurs fichiers.
- API locale et MCP : l’application expose une API locale et un serveur MCP, ce qui permet à vos scripts ou à des agents IA de lui confier des tâches vocales.
Choisir ses modèles
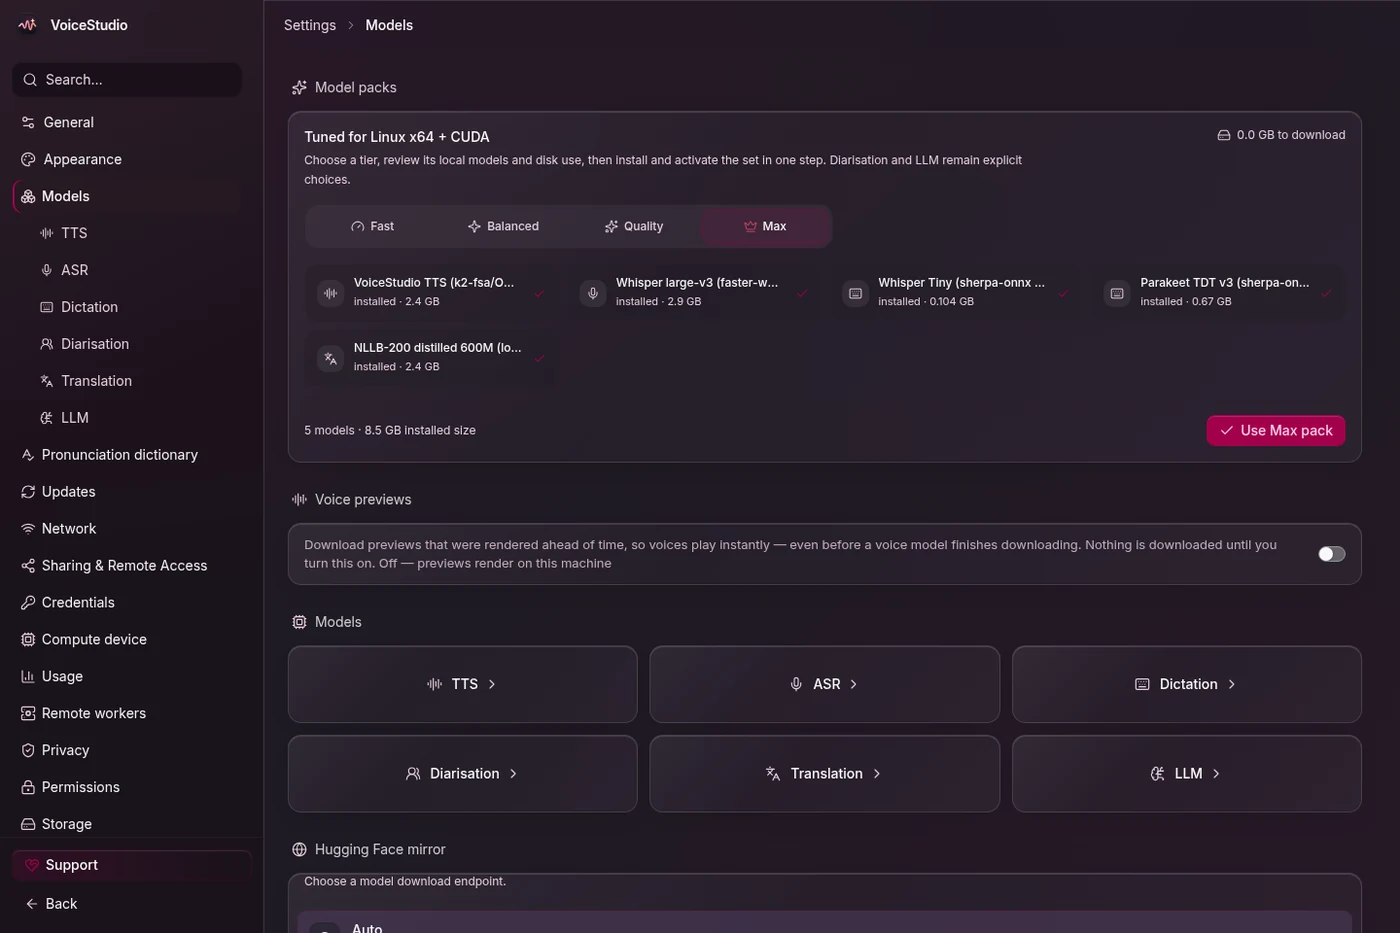
Un gestionnaire de modèles regroupe la synthèse, la reconnaissance, la dictée, la séparation des locuteurs, la traduction et un modèle de langage. Des « packs » de plusieurs niveaux installent un jeu cohérent en une étape : sur la capture officielle, le pack le plus complet pour Linux avec carte NVIDIA totalise 8,5 Go une fois installé. Prévoyez donc de la place disque.
Comment l’installer
Sur un ordinateur, le plus simple est de télécharger l’installeur de la dernière version sur GitHub. Le dépôt propose aussi un script d’installation pour macOS et Linux et un équivalent PowerShell pour Windows ; comme pour tout script exécuté directement après téléchargement, relisez-le avant de le lancer. Pour un serveur, un NAS ou une machine sans écran, l’équipe fournit une image Docker et un fichier Compose.
Avec Docker Compose
					# Récupérer le dépôt (il contient deploy/docker-compose.yml)
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio

# Clé d'administration : à générer une fois et à conserver
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"

# Profil CPU (--profile gpu pour une carte NVIDIA, --profile rocm pour une carte AMD)
docker compose -f deploy/docker-compose.yml --profile cpu up -d
L’interface s’ouvre ensuite sur http://localhost:3900, et le navigateur vous demande la clé d’administration. Le fichier Compose publie le port sur 127.0.0.1 : seule la machine locale y accède par défaut. La documentation indique que le premier démarrage télécharge environ 2,4 Go de modèles, alors qu’un commentaire du fichier Compose parle de 4 Go : prévoyez de la marge. Elle conseille aussi l’étiquette d’image stable pour un usage durable, l’étiquette latest suivant l’aperçu de la branche principale.
Pour ouvrir VoiceStudio sur votre réseau local, il faut modifier la publication du port et garder la clé. La documentation déconseille de l’exposer directement sur Internet : elle recommande un réseau privé chiffré, de type Tailscale ou ZeroTier. Pour mettre à jour, tirez la nouvelle image et recréez le conteneur.
Les limites à connaître
- Licences des modèles : la licence de l’application et celles des modèles sont distinctes. D’après le site, le modèle OmniVoice préentraîné est non commercial, et les notes de la version 0.5.7 indiquent que les modèles sans licence clairement commerciale, dont celui par défaut, demandent d’accepter leurs conditions une fois dans le catalogue. Pour un usage professionnel, lisez la page de licence de VoiceStudio et la fiche de chaque modèle.
- Fonctions passées en Pro : toujours selon ces notes, les appareils distants, les travailleurs distants et le partage de GPU ont quitté l’application open source pour l’édition Pro.
- Installation variable : le suivi d’anomalies du dépôt contient des retours d’utilisateurs sur l’installation (environnement Python jugé incomplet, serveur interne qui ne démarre pas, retéléchargement d’environ 3,5 Go sous Windows). Ce sont des signalements individuels, pas une statistique, mais ils rappellent que l’installation locale dépend de la machine.
- Signature des installeurs : les notes précisent que les installeurs Windows ne sont pas signés, donc SmartScreen peut avertir ; sur macOS, le dépôt documente un message de blocage par Gatekeeper. Le Mac Intel n’est que « limité » : l’interface s’y connecte à un serveur distant.
- Matériel : le site indique qu’environ 8 Go de mémoire suffisent pour démarrer, et le dépôt qu’une machine sans carte graphique reste utilisable, en plus lent.
- Suivi du projet : dans ces mêmes notes, l’auteur s’excuse d’un long délai entre deux versions et annonce l’arrivée d’un second mainteneur. Sur Hacker News, la présentation du projet n’a reçu aucun commentaire.
Cloner une voix : consentement et usage responsable
Le projet pose une règle simple : ne cloner une voix qu’avec l’accord de son propriétaire. Sa page d’usage acceptable interdit notamment l’usurpation d’identité, la fraude, y compris le contournement d’une authentification vocale, et le clonage de la voix d’un enfant. Pour un travail commercial, elle recommande de conserver une autorisation signée pour chaque voix, et de signaler qu’un audio est synthétique lorsque l’auditeur pourrait s’y tromper.
L’application tournant en local, l’éditeur reconnaît ne pas voir ce que vous générez : la responsabilité vous revient. Vérifiez le cadre légal qui s’applique à votre projet, et demandez un avis juridique en cas de doute.
Édition libre, Pro et Lifetime
L’édition libre de VoiceStudio est l’application open source présentée ici. L’édition Pro, vendue aussi en Lifetime, est un build distinct à code fermé, qui s’accompagne d’une licence commerciale pour le travail client, de trois appareils par utilisateur, d’un accès anticipé aux nouveautés et de fonctions réservées. La page de tarifs affiche 99 $ par an pour Pro ou 299 $ en paiement unique pour Lifetime, avec un remboursement sous sept jours, et propose une formule Enterprise sur demande. Une offre hébergée, VoiceStudio Cloud, est annoncée sans tarif.
Le site précise que l’usage de l’application au travail est permis dans l’édition libre comme dans Pro, et que Pro ne lève pas les conditions des modèles. Les montants et les conditions pouvant changer, lisez la page de tarifs et la page de licence officielles avant de choisir.
VoiceStudio face à ElevenLabs (service cloud payant)
Le site de VoiceStudio publie un tableau comparatif avec ElevenLabs : ce sont des affirmations du projet, établies à partir de pages publiques, que nous reprenons sans les avoir contrôlées une à une. Selon ce tableau, VoiceStudio tourne sur votre machine et garde votre audio en local, alors qu’ElevenLabs est un service en ligne où l’audio est envoyé.
Côté ElevenLabs, la page de tarifs liste une offre gratuite et des abonnements à crédits ; le clonage de voix instantané et la licence commerciale apparaissent à partir de l’abonnement Starter, le clonage professionnel à partir de Creator. Le service géré épargne l’installation et le matériel, un avantage que le tableau du projet ne mesure pas.
| Outil | Où ça tourne | Langues annoncées | Formule |
|---|---|---|---|
 VoiceStudio | Sur votre machine (macOS, Windows, Linux, Docker) | 646, selon les moteurs | Gratuit ; édition Pro payante |
 Voicebox | Sur votre machine (macOS, Windows, Docker ; Linux à compiler) | 23, selon le dépôt | Gratuit |
 ElevenLabs | Service cloud | Selon le modèle | Offre gratuite limitée ; abonnements à crédits |
Voicebox est une autre application locale et open source. Son dépôt annonce huit moteurs de synthèse, 23 langues, une dictée par raccourci global, ainsi qu’une API REST et un serveur MCP ; pour Linux, il indique que les binaires ne sont pas encore disponibles et renvoie vers une compilation depuis les sources. Le nombre de langues annoncé par chaque outil dépend des moteurs choisis et ne dit rien de la qualité.
Pour qui ?
- Les créateurs de contenu, vidéastes et formateurs qui veulent narrer, doubler ou sous-titrer sans envoyer leurs fichiers à un service tiers.
- Les développeurs et les équipes qui veulent brancher une voix ou une transcription locale à leurs scripts ou à leurs agents via l’API et le MCP.
- Les studios et indépendants qui ont besoin d’une licence commerciale et sont prêts à vérifier les conditions de chaque modèle.
- À éviter si vous voulez un service géré sans installation, si votre machine manque de mémoire ou d’espace disque, ou si vous ne pouvez pas contrôler la licence des modèles utilisés.
En résumé
VoiceStudio regroupe clonage de voix, conception de voix, doublage, dictée, transcription et livres audio dans une application locale et open source, sans compte, avec des éditions libre et Pro. Sa maturité est celle d’un projet en version 0.x, stable sur ordinateur et en préversion sur mobile selon son dépôt, et les licences des modèles demandent une vraie lecture. Si les modèles de langage locaux vous intéressent aussi, notre présentation de LM Studio explore la même logique sur Mac et PC. Pour installer et maintenir VoiceStudio sur un serveur, ou intégrer ses sorties à vos outils, contactez-nous : nous pouvons vous aider.